把576颗GPU连成一块?英伟达计划推出NVL576巨型算力平台
在AI大模型飞速迭代的今天,单张显卡的算力往往难以满足万亿级参数模型的训练需求,将海量GPU进行集群互联成为了行业的演进方向。10月23日,据最新消息,英伟达计划于明年推出基于Rubin Ultra架构的NVL576整机架方案。该方案的核心,是通过下一代CPO(光电共封装)与NVLink技术,将576颗GPU互联为一个统一的巨型GPU。
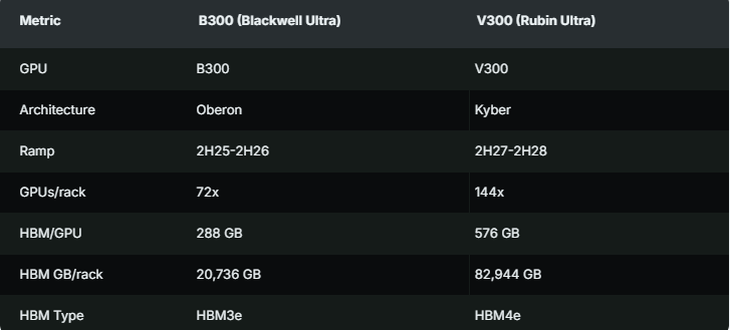
从官方公布的数据来看,这款平台的硬件跨度相当大。它主要瞄准10万亿参数级AI模型的训练与推理。在核心规格上,Rubin Ultra的单张显卡将搭载高达1TB的HBM4e显存,整个单机架的显存总带宽达到了惊人的4.6 PB/s。在计算性能方面,该系统在FP4精度下的推理性能为15 Exaflops,FP8训练性能为5 Exaflops。对比目前Blackwell架构的GB300 NVL72,其性能提升了14倍。对于复杂AI模型而言,更大的显存和带宽意味着能同时处理更多的数据,从而缩短训练周期。
在物理结构上,为了让这种庞然大物易于部署,Rubin Ultra采用了符合OCP标准的高度模块化设计。其计算托盘每个集成了两颗Rubin显卡和一颗Vera中央处理器。机架内部布满了被称为“黄色纤维”的光纤束,用于连接各个光学引擎。得益于这种模块化设计,原本需要数小时的传统物理安装过程,被缩短到了几分钟内即可完成。
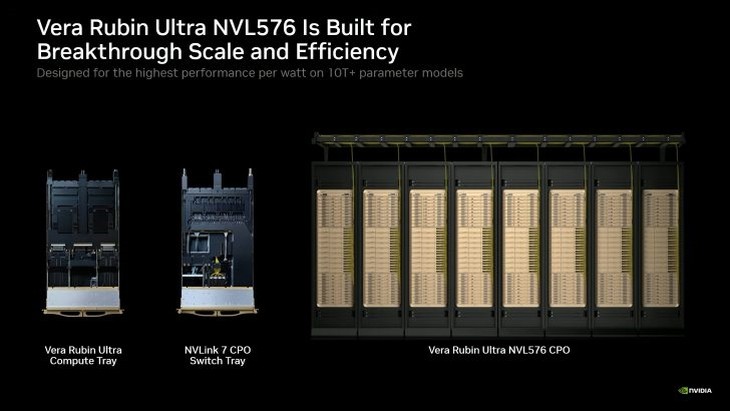
此外,针对此前业界对CPO技术可能延期的传闻,英伟达CEO黄仁勋在GTC柏林站上明确表示,CPO机架目前已进入大规模量产阶段。光互联技术替代传统的铜线互联,有助于在提升带宽的同时降低功耗。而Rubin Ultra正是首个全面挖掘该技术潜力的机架级系统。
将几百颗顶级GPU通过光互联技术打包成一个超级计算节点,反映出当下AI算力基础设施正朝着更高集成度、更高能效比的方向发展。这套系统最终在真实的大模型训练中能带来多少效率提升,明年产品落地后会有更清晰的答案。
关注我们