NPU从推理单元到协调中枢,骁龙新一代旗舰平台怎么做到的
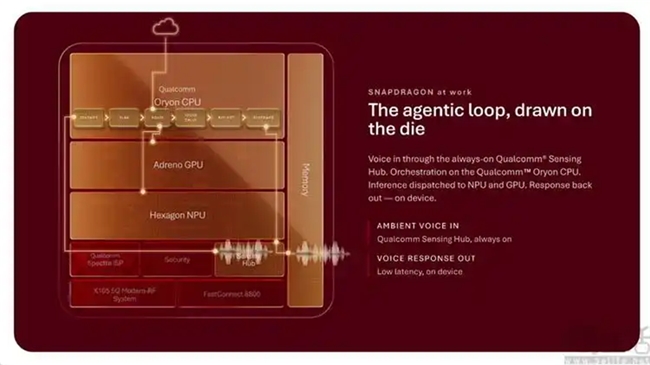
骁龙新一代旗舰移动平台发布在即,高通在官方博客中正式揭晓了其搭载的全新Hexagon NPU。这一次升级的核心,不仅仅是算力提升多少的简单叙事,而是一个更根本的转变:NPU的角色正在从执行单一模型的推理单元,变成调度多个专用模型的协调中枢。
高通技术公司产品市场高级总监Cisco Cheng在署名博客中给出了一个明确的判断:随着AI智能体化的深入,脱颖而出的架构不是依赖单一庞大模型处理所有任务,而是由多个专用模型组成的系统,根据任务、情境和用户需求进行智能调度。这句话,是理解新一代Hexagon NPU全部设计逻辑的钥匙。
高通做NPU,比大多数人想象的要早得多
很多人不知道,Neural Processing Unit(NPU)这个概念,最早就是高通提出的。2013年,高通发布了一个名为Zeroth的独立NPU项目,目标直指“定义一种全新的处理架构”——神经处理单元。到了2015年的骁龙820,高通已经将研究成果落地为实际能力:Hexagon 680 DSP实现了基于加速器的计算机视觉感知、低功耗语音唤醒和本地恶意软件行为分析。全时开启的传感器数据处理、随时在线的语音唤醒——这些功能在当时看足够超前,放到现在也不落伍。
2018年的骁龙855是另一个节点。高通在Hexagon 690中首次加入独立的张量加速器,让NPU正式具备针对深度学习模型的专用加速能力。从这一代开始,Hexagon NPU的架构轮廓逐渐清晰。
正因在这条路上走了很久,高通对于NPU应该怎么设计、如何使用,向来有自己的想法。
NPU升级的两个重点:计算更强,调度更顺
回到即将发布的骁龙新一代旗舰平台。高通公布的信息显示,NPU的改进集中在两个层面。
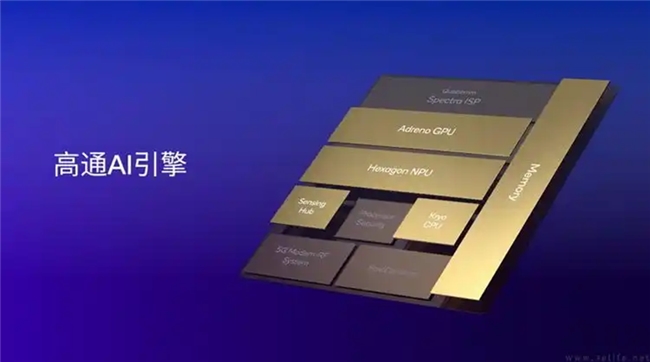
Element Accelerator:让NPU学会“调度”。 这是新一代Hexagon NPU最核心的变化。传统NPU的设计重心在“算”:把矩阵乘法做快。但智能体需要的不只是“算”,还需要“想”:在推理过程中选择走哪条路、调用哪个工具、下一步做什么决策。Element Accelerator让NPU第一次同时具备高效计算和智能调度两类能力,配合Fast Action Loops和KV-Cache加速,支持最长32K的上下文长度。
共享内存扩容50%:让数据留在该留的地方。端侧大模型推理有一个反直觉的工程现实:解码阶段的瓶颈往往不在计算,而在数据搬运。模型每生成一个词元,都需要读取保存对话上下文的KV缓存。如果NPU片上空间不足,数据就必须在NPU与主内存之间频繁搬移,推高时延和功耗。共享内存扩容后,更多数据留在NPU内部,减少DDR访问频次。用高通的话说,这让智能体在处理更长上下文、调用更多工具以及执行并发任务时,始终保持流畅响应。
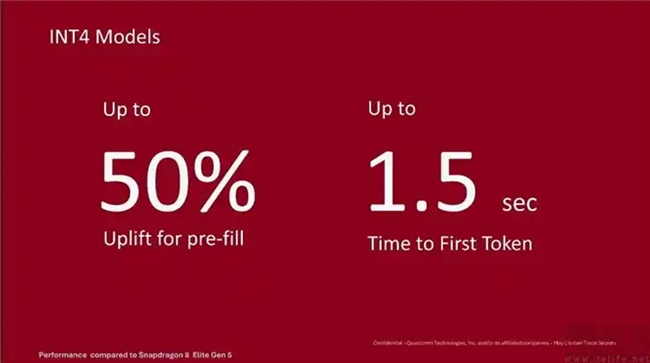
在模型层面,新一代NPU支持在终端侧运行300亿参数的MoE模型,每次生成词元仅激活约30亿个被路由选中的参数。配合从闪存到内存的智能加载机制和INT2到FP16的五种精度策略,开发者可以根据任务复杂度灵活平衡性能、内存和功耗。对于INT4精度模型,预填充性能提升最高50%,40亿参数模型首个词元生成时间低于1.5秒。
不只是旗舰的事,更是在为端侧AI铺路
自智能手机出现“AI”概念以来,已有十余年。但大多数用户真正用过的AI功能,几乎都是厂商预装的——第三方应用绝大多数时候仍然依赖云端处理,很少调用设备的端侧算力。根本原因在于,旗舰与非旗舰的AI性能落差太大,开发者不敢轻易将端侧AI在大众应用上落地。
高通显然看到了这个问题。新一代Hexagon NPU支持多种精度策略,本质上是为开发者提供更大的灵活度;与内存和模型厂商合作推进MoE架构,则是为了以更低的内存需求实现更大的模型体验。这些技术如果能够“下放”到更多设备,受益的绝不仅限于新一代旗舰。
更值得关注的是高通的自研架构优势。由于骁龙平台的CPU、GPU、NPU全部自研,高通能更容易地打通这几个计算组件,让复杂的AI任务被拆解到多个单元里协同执行。手机的AI能力,不再局限于NPU的规格。这或许才是新一代Hexagon NPU最值得期待的地方——它不只是让旗舰手机跑得更快,更是在为整个行业的端侧AI落地铺路。
关注我们