AI 搜索工具怎么选:一款为智能体而生的搜索基础设施 AnySearch 详解
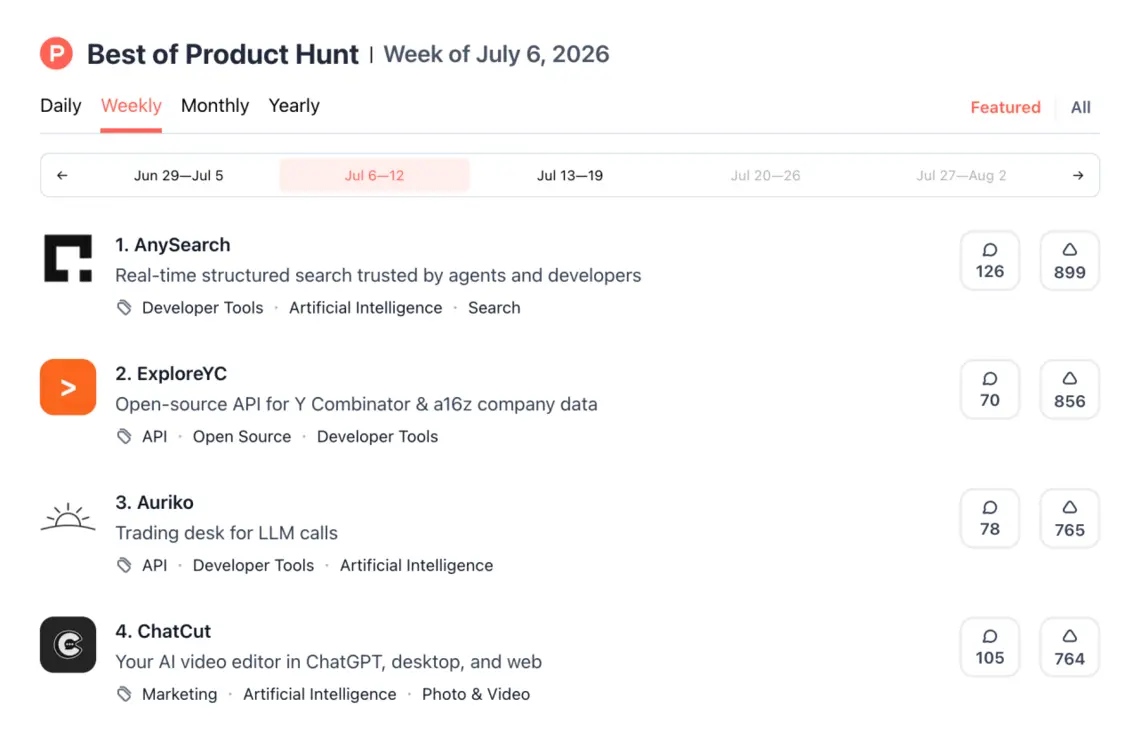
找一款合适的 AI 搜索工具,是不少智能体开发者绕不开的一步。今年,国内团队打造的搜索基础设施 AnySearch 登上了 Product Hunt 周度热门榜单。在一段时间里,行业视线多集中在智能体框架、AI 编程环境和大模型本身,面向搜索这一环的产品相对稀少,AnySearch 的出现填补了这一空位。
从公开的测试数据看,在由 Frames、FreshQA、WebwalkerQA 三组基准构成、合计约三百道问题的综合评测中,全程调用同一大模型作对照的前提下,AnySearch 取得了 76.4% 的综合准确率,在响应延迟方面也有可圈可点的表现。它的定位并不复杂:不和聊天机器人争抢 "对话" 这件事,而是站在更底层,为各类智能体提供结构化、可溯源、时效性强的知识供给。
一、它到底是什么:给 Agent 用的数据接口,而不是给人看的搜索引擎
多数开发者熟悉的搜索逻辑,是为人设计的 —— 输入关键词,返回一串链接和摘要,由人决定点进哪一页。AnySearch 换了一个视角:它默认的读者不是人,而是程序。
这意味着它不再把 "链接列表" 当作最终交付物,而是把公开网页和专业数据库中的内容,经过清洗、去重和结构化之后,以机器容易解析的形式返回。打个比方,如果说 Stripe 解决了智能时代的资金结算、Twilio 解决了通讯通道,那么 AnySearch 想解决的,就是智能体在执行任务时 "去哪找、找回来什么" 的那一段链路。
二、谁会用它:从独立开发者到专业团队
从产品适配的人群来看,主要是两类使用者。
一类是独立开发者和重度智能体用户。他们日常使用 Cursor、Claude Code、OpenClaw、Hermes 等工具写代码、做研究,需要一条稳定、低维护成本的检索通道,让自己的 Agent 能持续拿到新内容。
另一类是有联网需求的组织级项目。比如做金融分析、法律研究、网络安全和软件工程的团队,这些场景对信息的专业度、时效性和可追溯性要求较高,普通网页内容往往难以直接支撑下游推理,需要更靠近专业数据源的检索层。
三、为什么传统网页喂给 Agent 会 "水土不服"
在讲产品价值之前,有必要先把问题说清楚。当前不少 AI 检索方案,做法是把网页 URL、标题和摘要交给智能体,让模型自己去判断读哪一页。这套流程对人很自然 —— 扫一眼标题就知道值不值得点。但对智能体来说,未清洗的完整网页会带来几个现实问题。
页面里混着广告、导航、相关推荐,还有不少为迎合搜索排名而堆砌的段落,真正有信息量的内容占比并不高。如果把这些内容原样塞进上下文,模型的注意力会被稀释,有效 Token 被无效信息占用,幻觉风险也会随之上升。理想的做法,是在送到模型之前,先把噪音过滤掉,只留下核心事实和来源。
AnySearch 要做的就是这件事 —— 它不试图替代大模型,而是替大模型把 "取数" 这一步做扎实,让智能体拿到的是可以直接进入推理流程的文本,而不是还需要二次加工的网页原稿。
四、三个核心价值:把 "取数" 做成一件标准化的事
落到产品层面,AnySearch 的价值主要体现在三个方面。
第一是接入标准化。开发者只需对接一个统一的 API,就能跨多个领域获取素材,不必再为每一类数据源单独写连接器、做适配和维护。工程团队因此可以把精力放在自己的业务逻辑上,而不是耗在数据搬运的琐碎工作里。
第二是对机器友好。它默认返回 Markdown 格式,自动剥离网页中的推广元素和冗余标签,保留正文和代码块。这种输出方式对下游大模型更友好,既能减少无效 Token 占用,也便于模型直接引用内容。在集成方式上,它同时支持 API、MCP 和 Skill 三种形态。
第三是专业场景覆盖广。除了公开网络信息,它还整合了一批垂直领域的高价值素材,使金融、法律、代码、行业研究这类对深度有要求的任务,不必再只依赖通用搜索结果。
五、支撑这些体验的四层后台机制
前面提到的能力,背后是四组机制在协同工作。
意图识别与请求分发。 系统在收到查询的瞬间,会对自然语言做语义理解和归类,再把请求送到更匹配的资料库,而不是对所有问题都走同一条通用检索路径。举个例子,当用户想写一份上市公司研报时,系统会把查询导向企业资质和司法类数据库,而不是停留在新闻层面,一次请求就能带出年报、诉讼记录等结构化素材,后续整理的效率自然更高。
通用索引加垂直索引的联邦检索。 它的信息池由两部分组成:一部分是覆盖面广的通用索引,满足日常长尾查询;另一部分是自建的专业索引,覆盖金融、法务、网络安全、行业调研等二十多个细分方向。通过跨源调度,系统可以在多个来源之间组合结果,减少对单一外部数据源的依赖。
网页清洗与结构化通道。 这一层负责把杂乱的 HTML、页面残留和推广板块,转成干净、排版规整的 Markdown 文本。开发者不需要自己写一堆解析规则去抠正文和代码块。比如想找一段算法实现时,返回结果里可以直接看到完整的代码段,复制进工程即可使用。
隐私与不留存策略。 平台采用无数据驻留、兼容匿名请求的方式处理查询,所有请求只在内存中即时处理,任务结束后不长期留存检索痕迹。对于做量化交易、大宗研判这类涉及策略机密的团队,这一点比较关键 —— 查询词和业务意图不会被沉淀下来,也不会被用于模型训练。
六、三种接入方式与免费额度
为了适应不同的开发习惯,AnySearch 提供了三条集成路径。
一是 Skill 技能组件,可以直接作为智能体的扩展能力安装,在工作流界面里启用后即可建立数据通路。
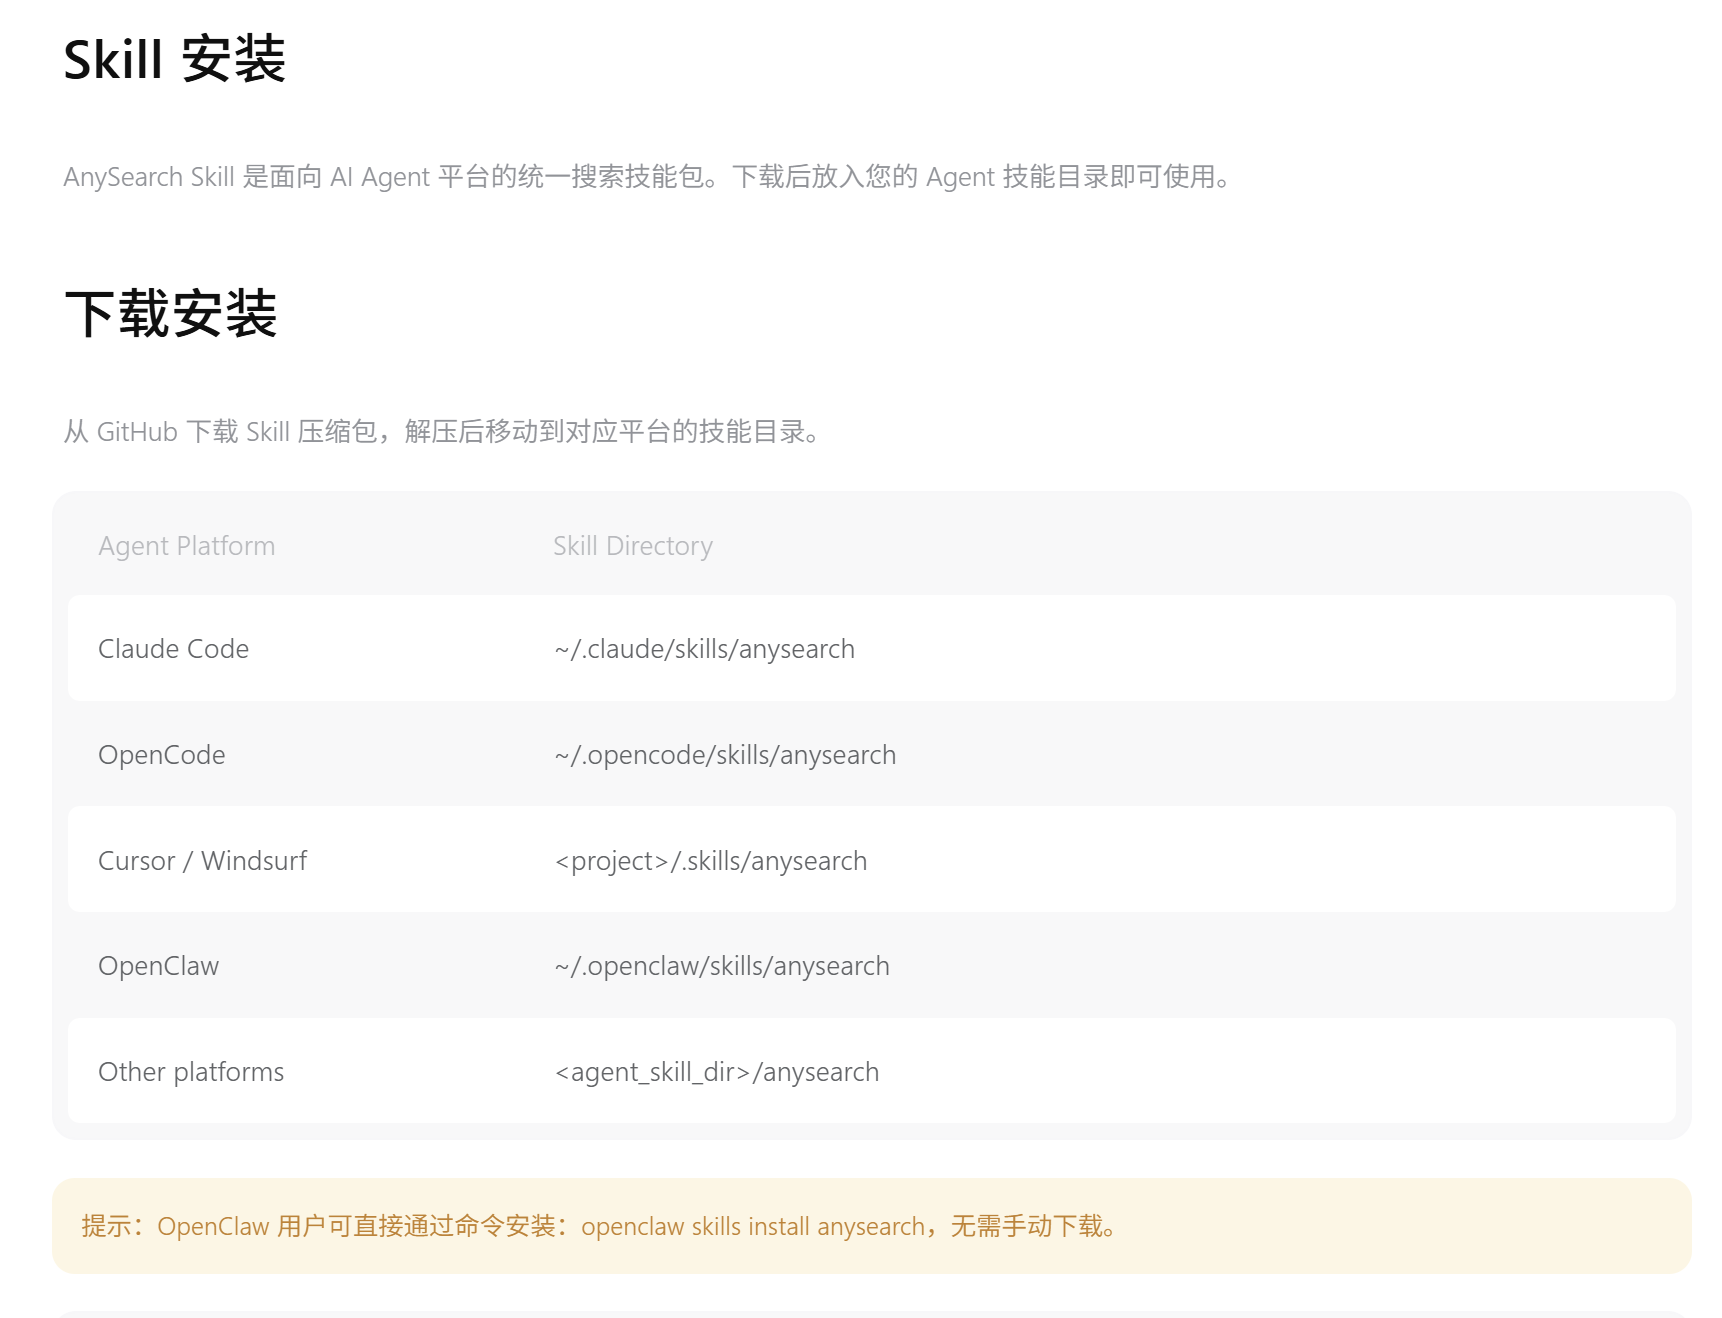
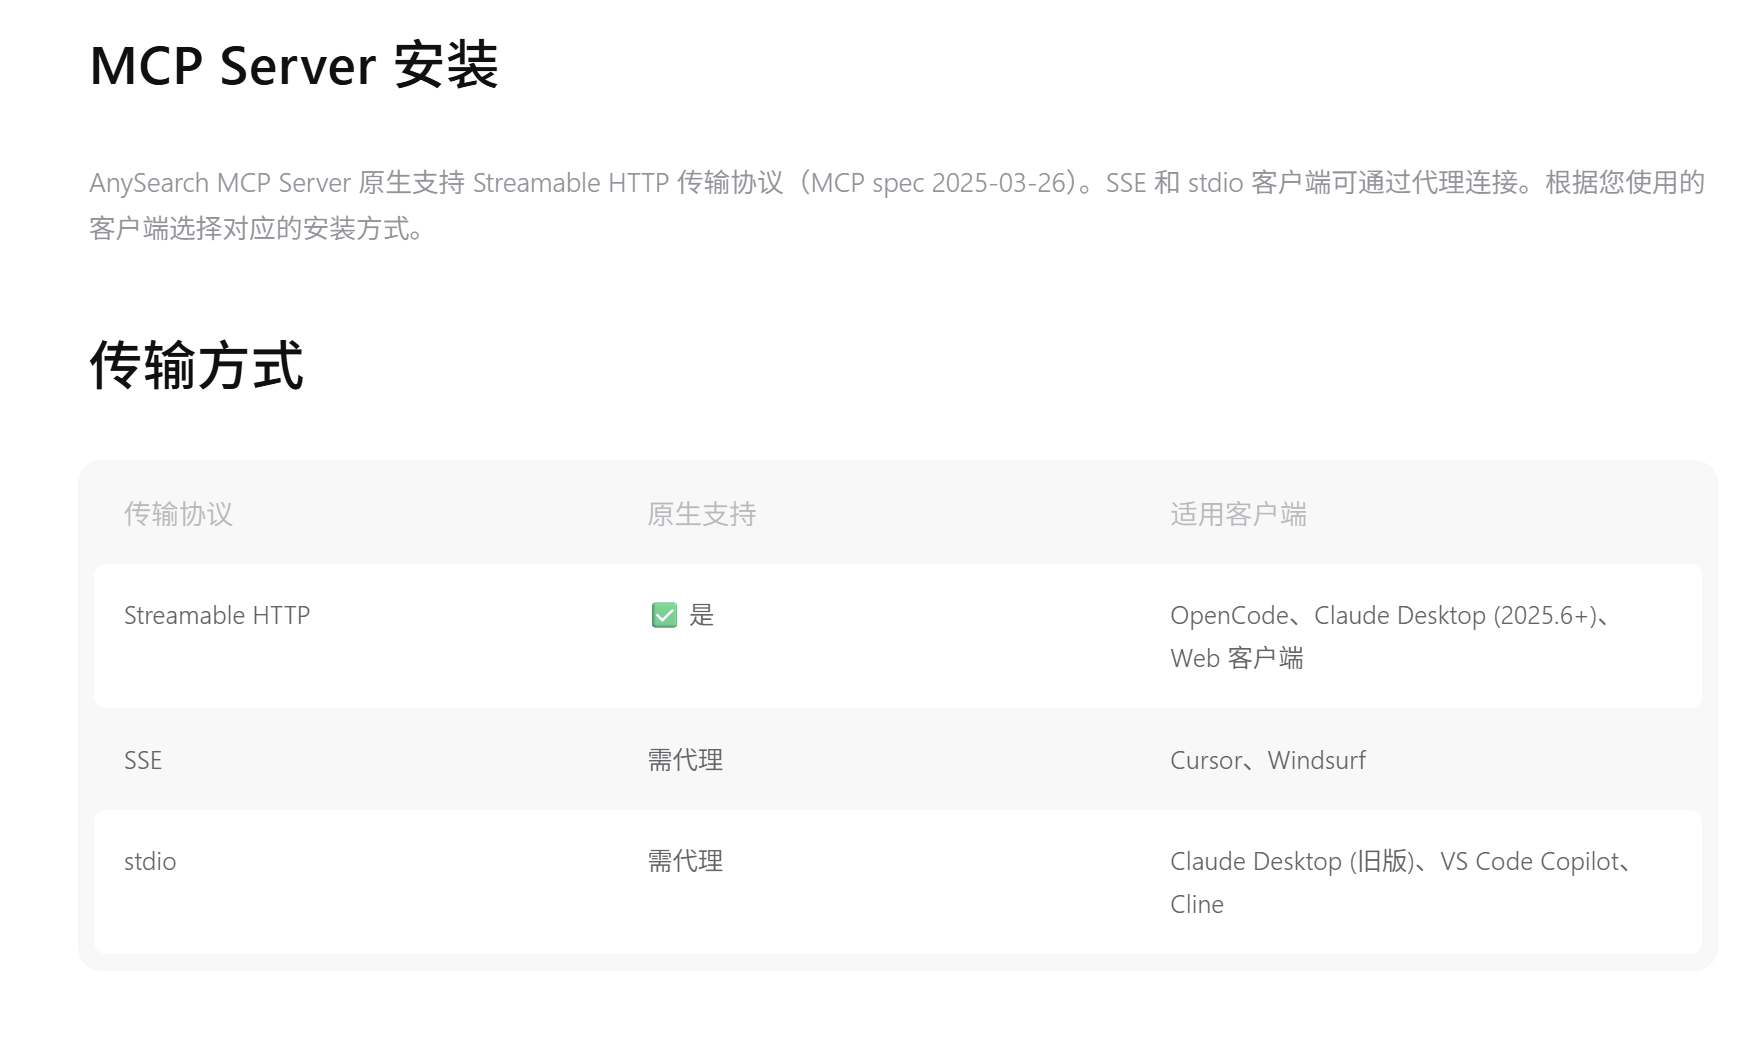
二是 MCP 协议,原生支持 Model Context Protocol,Cursor、Claude Desktop、OpenClaw 等常见智能体应用可以对接上手。
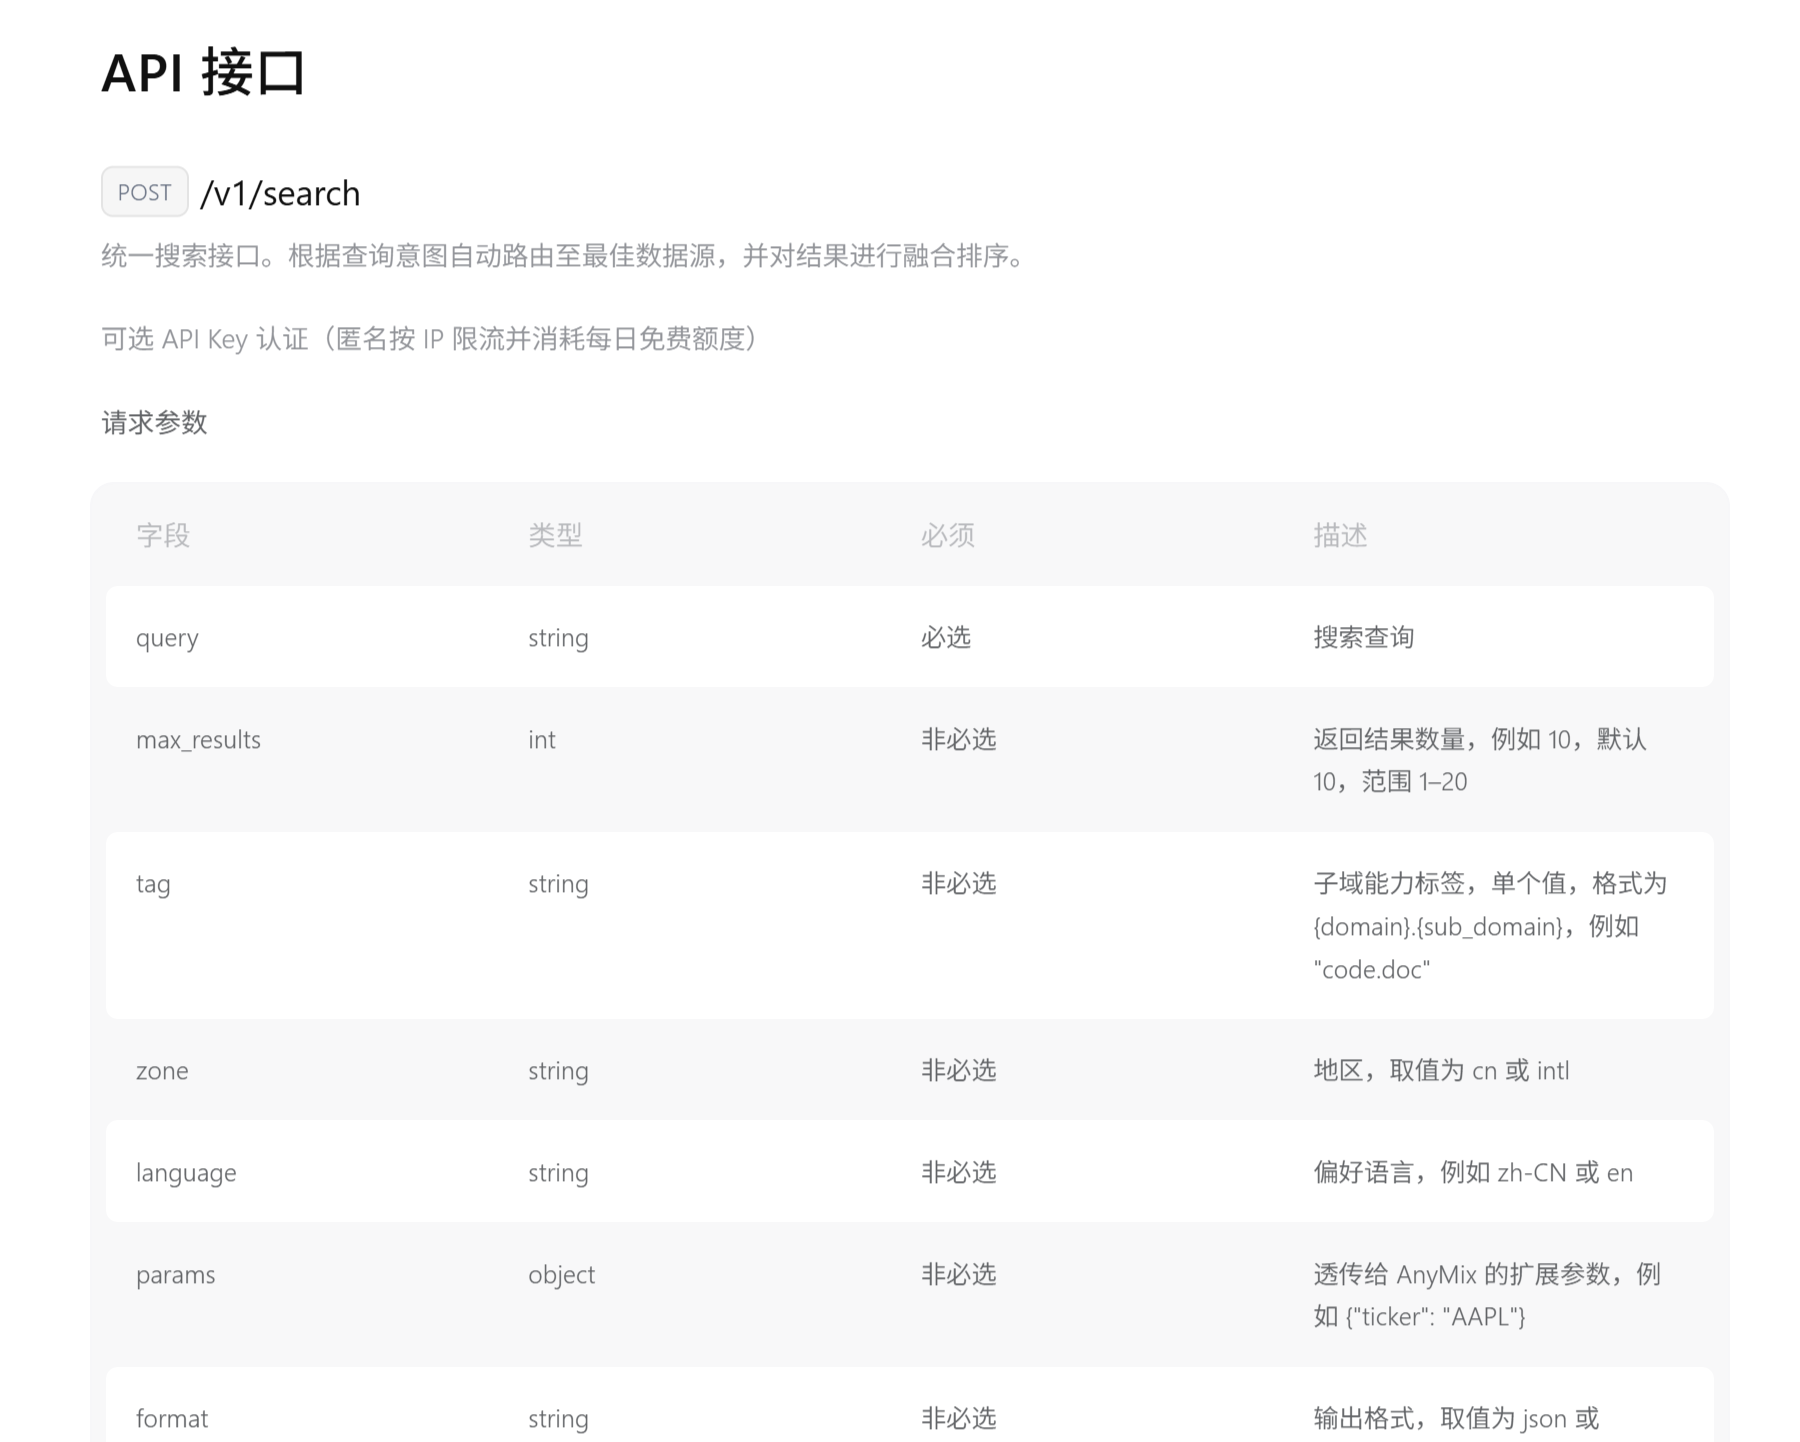
三是标准 REST API,采用 POST 方式,端点为 https://api.anysearch.com/v1/search,方便接入各类编程语言和自建的业务后台。
收费上,它对独立开发者采取长期免费政策,注册后每天提供 1000 次免费请求额度,意图分发、专业库检索、Markdown 转换等核心能力都包含在内,不做功能阉割。有高频调用或内网私有化需求的团队,可以进一步了解面向企业场景的定制方案。
七、小结:智能体时代的 "取数层"
整体来看,AnySearch 解决的是智能体工作流里一个容易被忽视、却直接影响效果的环节 —— 信息从哪里来、以什么形式来。它通过文本清洗、专业索引和不留存的安全设计,让送到模型面前的内容更干净、更贴题、也更可追溯。
从早期测试者的反馈看,这类差异在对时效和来源敏感的场景里会被放大。比如为量化交易智能体抓取海外市场动态时,出处去重和时效性优先的策略,能让模型更快定位到有参考价值的商业信息,而不是被过期内容带偏判断。
如果你正在为自己的 Agent 挑一条检索通道,可以先用每日免费额度做一轮原型验证,再决定是否接入更深的业务流程。对于搜索这一环,工具选得合不合适,最终都会反映在智能体回答的质量上。
关注我们